一个强大的本地 MCP Server,用于智能读取 Java 源代码。支持从 Maven 依赖(JAR 包)中提取源码,配备双反编译器(CFR/Fernflower)自动选择机制,智能处理 SNAPSHOT 版本,让 AI 助手能够深入理解你的 Java 代码库。
A powerful MCP (Model Context Protocol) server for intelligently reading Java source code. Supports extracting source code from Maven dependencies, equipped with dual decompiler (CFR/Fernflower) auto-selection mechanism and intelligent SNAPSHOT version handling. Empowers AI assistants to deeply understand your Java codebase.
- 🤖 AI 友好的智能提示:所有工具都具备智能错误提示机制,当查询失败时主动引导 AI 助手调整策略,有效减少幻觉和重复尝试
- 📦 从 Maven 仓库读取源代码:自动从本地 Maven 仓库(支持启动参数、
MAVEN_REPO和 Maven settings 配置)中查找和读取 JAR 包源代码 - 🔍 源码读取:优先从 sources JAR 提取源码,其次复用磁盘缓存,缓存不可用时反编译原始 JAR
- 🛠️ 双反编译器支持:根据运行时 Java 版本选择 CFR 或 Fernflower,失败时尝试兼容的备用反编译器
- ⚡ 智能缓存机制:反编译结果保存在 Maven 版本目录,SNAPSHOT 使用最新时间戳包名管理缓存,校验实际输入包的大小与修改时间
- 🔄 SNAPSHOT 支持:普通 SNAPSHOT 主包优先读取,最新时间戳包名用于管理缓存
- 📄 按行读取:默认返回全文,也可通过
start_line、end_line指定阅读范围
Easy Code Reader 特别适合与 Claude、ChatGPT 等大模型配合使用,接下来以 VSCode 结合 Copilot 为例,介绍一些最佳实践:
在使用第三方依赖时,可以让 AI 助手通过 MCP 获取指定版本的源码,结合真实实现进行分析。在 Easy Code Reader 中提供了 read_jar_source 工具来读取 jar 包中的源码,帮我们完成开发实现。以下面代码为例,现在我想实现多个服务实例的注册,但是我又不了解 NamingService 的实现,便可以借助 read_jar_source 来完成:
public class Main {
    private static final Logger logger = LoggerFactory.getLogger(Main.class);

    public static void main(String[] args) throws NacosException, InterruptedException {
        logger.info("开始初始化 Nacos 客户端...");

        Properties properties = new Properties();
        properties.put(PropertyKeyConst.SERVER_ADDR, "127.0.0.1:8848");
        properties.put(PropertyKeyConst.NAMESPACE, "7430d8fe-99ce-4b20-866e-ed021a0652c9");

        NamingService namingService = NacosFactory.createNamingService(properties);

        System.out.println("=== 注册服务实例 ===");
        try {
            // 注册一个服务实例
            namingService.registerInstance("test-service0", "127.0.0.1", 8080);
            // 添加事件监听器
            namingService.subscribe("test-service", event -> {
                System.out.println("服务实例变化: " + event);
            });
            // 注册多个服务实例

        } catch (Exception e) {
            System.out.println("服务注册失败(预期,因为服务器可能未启动): " + e.getMessage());
        }

        TimeUnit.HOURS.sleep(3);
    }
}
你是一位 Java 技术专家,精通 Nacos 框架,请你帮我在 #file:Main.java 中完成注册多个服务实例的逻辑,在编写代码前,你需要先使用 easy-code-reader 的 read_jar_source 工具读取 com.alibaba.nacos.api.naming.NamingService 的源码信息来了解注册多个服务实例的方法
处理过程如下所示:
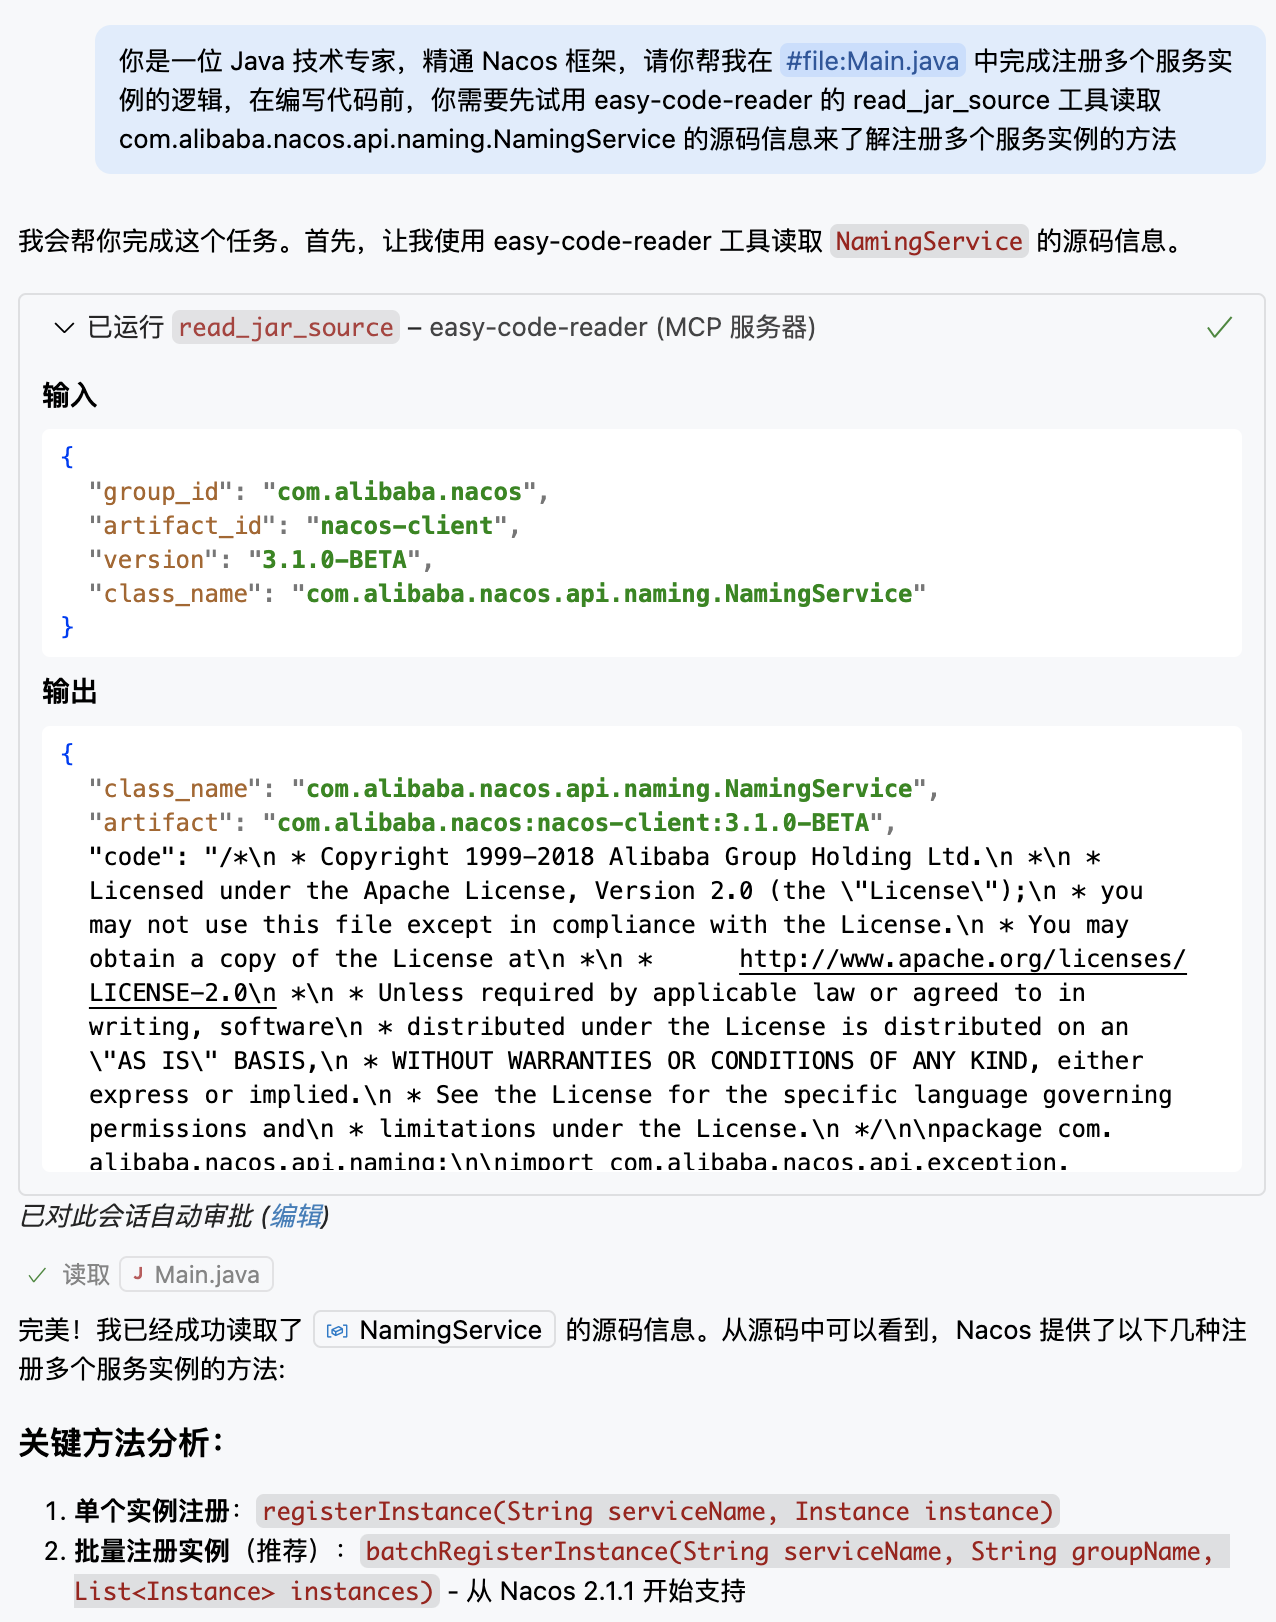
这样我们便能够快速地了解 NamingService 的实现细节,从而完成代码编写工作,节省了大量时间。
还可以使用 Easy Code Reader 完成以下事项:
- 异常问题快速溯源:如果有异常信息是外部 jar 包依赖中抛出来的,可以使用
read_jar_source工具根据异常堆栈日志快速定位异常点 - 依赖升级影响评估(旧/新版本差异核对):同样是使用
read_jar_source工具来完成新旧版本的实现差异,评估升级影响
- Python 3.10 或更高版本。
- uv:用于下文的安装和运行命令。
- Java:生成反编译结果时需要
java在 PATH 中,建议使用 JDK 11 或 21。直接读取 sources JAR 或有效缓存时无需启动 Java。 - 运行自动测试需要
javac,测试脚本使用javac --release 8;建议同样使用 JDK 11 或 21。 - 使用 Inspector 浏览器调试时,需要 Node.js 22.19.0 或更高版本及
npx。
以下两种接入方式运行包源中的已发布版本。调试当前仓库代码请使用本地开发与验证和 Inspector 调试。
如果您还没有安装 uv,可以通过以下方式快速安装:
# macOS/Linux
curl -LsSf https://astral.sh/uv/install.sh | sh

# Windows
powershell -c "irm https://astral.sh/uv/install.ps1 | iex"
或者参考 uv 官网 进行安装,并配置 uv 的安装路径添加到系统 PATH 中,以便可以直接使用 uvx 命令。uv 是一个极快的 Python 包和项目管理工具。使用 uvx 可以无需预先安装,直接运行,使用 mcpServers JSON 配置格式的客户端可参考以下示例:
--maven-repo: 指定 Maven 仓库路径,将/custom/path/to/maven/repository内容替换为本地 Maven 仓库路径即可,不配置时依次读取MAVEN_REPO、用户 settings、Maven 全局 settings,最后使用~/.m2/repository
{
  "mcpServers": {
    "easy-code-reader": {
      "command": "uvx",
      "args": [
        "easy-code-reader",
        "--maven-repo",
        "/custom/path/to/maven/repository"
      ],
      "env": {}
    }
  }
}
将以上内容配置好后,AI 助手即可通过 MCP 协议调用 Easy Code Reader 提供的工具,完成 Maven 依赖的 Java 源代码读取工作。
如果使用 快速接入(方法一) 安装运行失败,那么可以采用直接安装到本地的方法,运行如下命令:
uv tool install easy-code-reader安装成功后,执行以下命令获取安装目录:
which easy-code-reader比如,输出结果是:/Users/fangyuan/.local/bin/easy-code-reader,则将它填入 MCP 客户端的 command,启动参数填入 args:
{
  "mcpServers": {
    "easy-code-reader": {
      "command": "/Users/fangyuan/.local/bin/easy-code-reader",
      "args": [
        "--maven-repo",
        "/custom/path/to/maven/repository"
      ],
      "env": {}
    }
  }
}
一般这样操作都能完成安装,后续如果有版本更新,可以通过以下命令进行升级:
uv tool install --upgrade easy-code-readeruv 命令未找到,确保已正确安装 uv 并将其路径添加到系统 PATH 中,参考 环境要求,并尝试重启 IDE 后再启动 MCP Server。
可先在终端按快速接入(方法二)完成安装,再配置 MCP 客户端;调试本地源码时,也可按本地开发与验证使用已安装的 Python 创建环境。
Easy Code Reader 提供两个工具,用于查找 Maven 坐标和读取 JAR 包源码。
根据 artifactId 和可选的 groupId 前缀,在本地 Maven 仓库中查找 groupId 及可用版本,辅助调用 read_jar_source。
参数:
artifact_id(必需):不含版本号的 Maven artifact ID,例如spring-core。group_prefix(可选):完整 groupId 前缀(按点号分段匹配,不区分大小写),例如org.springframework,用于缩小搜索范围。version_hint(可选):版本子串,例如5.3.21或SNAPSHOT;不确定版本时可不传。
每次调用都直接搜索当前 Maven 仓库,不缓存搜索结果。新依赖安装或删除后,下次搜索即可反映变化。
示例:
{
  "artifact_id": "spring-core",
  "group_prefix": "org.springframework",
  "version_hint": "5.3.21"
}
返回内容:
matches:按 groupId 排序的候选列表,每项包含group_id、matched_versions(按 Maven 版本顺序降序排列,最多 10 个)和total_versions。total_matches:匹配的 groupId 数量。search_stats:实际扫描目录数和耗时;scanned_groups保留为扫描目录数的兼容字段。hint:后续操作建议。
典型工作流:
- 使用
search_group_id查找 groupId 和可用版本。 - 从结果中选择正确的 Maven 坐标。
- 使用
read_jar_source读取指定类的源码。
没有匹配结果时,检查 artifact ID 拼写,放宽 group_prefix 或移除 version_hint 后重试。
从本地 Maven 依赖读取 Java 类源码,依次尝试 sources JAR、反编译缓存和原始 JAR 反编译。
参数:
group_id(必需): Maven group ID,例如org.springframeworkartifact_id(必需): Maven artifact ID,例如spring-coreversion(必需): Maven version,例如5.3.21class_name(必需): 完全限定的类名,例如org.springframework.core.SpringVersionprefer_sources(可选,默认true):优先读取 sources JAR;设为false时跳过源码包,但仍会复用有效的反编译缓存。start_line/end_line(可选):从 1 开始,包含首尾;不传时保持全文返回。只传一端时读取到对应文件边界。起始行越界或范围倒置返回错误,结束行超过文件长度时取文件末尾。
读取流程:
- 校验参数,定位 Maven 依赖;二进制主包存在时,先确认目标
.class条目及基本文件头有效。 prefer_sources=true时,尝试从 sources JAR 读取目标源码;支持只有源码包的依赖版本。- 源码不可用时,检查
easy-code-reader/下的正式缓存。缓存有效则直接返回。 - 缓存未命中时,反编译器直接读取原始 JAR,反编译整个包,再从结果中读取请求类的源码。
- 结果校验并写入正式缓存后,执行缓存容量清理和本次临时目录清理,然后返回源码。
SNAPSHOT 选择规则:
| 仓库中的主包 | 实际反编译输入 | 缓存文件名 |
|---|---|---|
| 普通 SNAPSHOT 和时间戳包都存在 | 普通 SNAPSHOT 主包 | 最新时间戳主包名 |
| 只有普通 SNAPSHOT 主包 | 普通 SNAPSHOT 主包 | 与主包同名 |
| 只有时间戳主包 | 最新时间戳主包 | 与该时间戳包同名 |
时间戳按日期时间和数字构建号排序。普通 SNAPSHOT 主包优先使用普通 sources,缺失时尝试该时间戳构建的 sources;直接读取时间戳主包时匹配其 sources。普通发布版本精确匹配主包及对应 sources。
内部类名使用 Outer$Inner,必要时返回包含它的外部类源码并附带提示。仅有 sources JAR 时也可以读取;tests、all 等 classifier 包不会被当作主包。
错误处理:
失败时 MCP 响应设置 isError=true,文本内容中的 JSON 包含 error.code、error.message 和 error.hint。例如:
{
  "error": {
    "code": "ARTIFACT_NOT_FOUND",
    "message": "未找到 JAR 文件: org.example:demo:1.0",
    "hint": "使用 search_group_id 核对 Maven 坐标。"
  }
}
常见错误码包括 INVALID_ARGUMENT、CONFIG_ERROR、ARTIFACT_NOT_FOUND、CLASS_NOT_FOUND、SOURCE_DECODE_ERROR、INVALID_JAR、DECOMPILER_UNAVAILABLE、DECOMPILE_FAILED、DECOMPILE_TIMEOUT、CACHE_UNAVAILABLE 和 INPUT_CHANGED。
JAR 缺失时可先用 search_group_id 核对坐标;依赖需要预先通过 Maven 下载或安装到本地仓库。反编译失败会返回错误说明。
示例:
{
  "group_id": "org.springframework",
  "artifact_id": "spring-core",
  "version": "5.3.21",
  "class_name": "org.springframework.core.SpringVersion"
}返回结构示例(code 已简化):
{
  "class_name": "org.springframework.core.SpringVersion",
  "artifact": "org.springframework:spring-core:5.3.21",
  "source_type": "sources.jar",
  "code": "package org.springframework.core;\n\npublic class SpringVersion {\n    // ...\n}"
}
全文读取仅返回上面四个字段。显式传入行范围时,另外返回 total_lines、start_line、end_line 和 is_partial。内部类映射或源码解码回退等特殊情况可附带简短的 warnings。实际 JAR 路径和解析版本仅用于内部处理及调试日志。
source_type 字段说明:
source_type 字段标识源码的来源,帮助 AI 助手了解代码的可靠性和新鲜度:
"sources.jar":从本地 sources JAR 提取的源文件"decompiled": 通过反编译器新反编译生成(可能存在反编译不完整的情况)"decompiled_cache": 从之前反编译的缓存中读取(避免重复反编译,提升性能)
💡 使用建议:
- 有 sources JAR 时优先阅读其中的原始源码
decompiled来源的代码可能会有语法糖恢复、泛型擦除等反编译特征decompiled_cache与decompiled质量相同,只是从缓存读取以提升效率
easy-code-reader/
├── src/easy_code_reader/
│   ├── __init__.py          # Python 包入口
│   ├── __main__.py          # 程序入口点
│   ├── server.py            # 两个 MCP Tool 与使用指南
│   ├── service.py           # 源码读取流程
│   ├── repository.py        # Maven 文件解析与实时搜索
│   ├── versions.py          # Maven 版本排序
│   ├── source.py            # 内部类、源码提取与行范围
│   ├── cache.py             # 按 JAR 名称保存的磁盘缓存
│   ├── errors.py            # 统一错误
│   ├── io_utils.py          # 可安全取消的文件操作调度
│   ├── config.py            # 配置管理
│   ├── decompiler.py        # 反编译器集成
│   └── decompilers/         # 反编译器 JAR 文件目录
│       ├── fernflower.jar   # Fernflower 反编译器
│       └── cfr.jar          # CFR 反编译器
├── tests/                   # 测试文件
├── scripts/                 # MCP 冒烟验证与发布脚本
├── docs/CHANGELOG.md         # 版本变更说明
├── pyproject.toml           # Python 项目配置
├── requirements.txt         # Python 依赖
└── README.md                # 本文档
按运行时 Java 版本选择优先使用的反编译器:
| Java 运行时版本 | 优先使用 | 说明 |
|---|---|---|
| 6–20 | CFR | 使用随包提供的 decompilers/cfr.jar |
| 21 及以上 | Fernflower | 使用随包提供的 decompilers/fernflower.jar,失败时可尝试 CFR |
只有满足 Java 运行要求且文件可用的反编译器会被执行;尝试备用反编译器也计入同一次请求的超时预算。Fernflower 显式开启泛型签名恢复(-dgs=1),以保留字节码中已有的泛型信息。反编译结果仍可能存在语法糖等还原差异。
缓存直接保存在实际 JAR 所在版本目录的 easy-code-reader/ 下,无需单独配置缓存路径。普通版本与原始 JAR 同名;SNAPSHOT 有时间戳包时使用最新时间戳包名,否则使用普通 SNAPSHOT 包名。
~/.m2/repository/org/example/demo/1.0-SNAPSHOT/
├── demo-1.0-SNAPSHOT.jar            # 优先作为反编译输入
├── demo-1.0-20260916.120000-2.jar    # 用于确定缓存版本名称
└── easy-code-reader/
    └── demo-1.0-20260916.120000-2.jar
最新时间戳包名变化时使用新的缓存文件。缓存内部记录实际读取的输入包的大小和修改时间;普通 SNAPSHOT 包更新后,即使时间戳文件名不变也会重新生成缓存。若同名文件被覆盖且大小、修改时间均未变化,需要手动删除对应缓存。
缓存命中时直接读取磁盘文件。缓存缺失时,反编译器直接读取解析出的原始 JAR,并将中间输出写入独立临时目录;反编译结果经过校验、确认原始文件未发生变化后,通过原子替换写入正式缓存。并发请求使用各自的临时输出目录,完成后清理。
每次新缓存生成后,按该版本目录默认 1 GiB 的预算清理较久未使用的新格式缓存。本次刚生成的缓存不在该次清理中删除,因此预算可能暂时超过。已有同名缓存缺少输入校验信息时,在下一次读取对应 JAR 时重新生成。
反编译需要对应 Maven 缓存目录可写,权限不足时明确报错;直接读取 sources JAR 不需要写入缓存。Python 安装目录无需写权限。
--decompile-timeout:反编译请求预算,默认 60 秒;超时/取消会终止并回收 Java 进程。- 日志只输出到 stderr,不在安装目录创建文件。
- 源码使用严格 UTF-8 解码;失败可回退到对应二进制包,并附带
warnings。 - MCP 调用等待源码读取或反编译完成后一次性返回结果;异步子进程让服务器在等待 Java 时继续处理其他请求及取消,不返回后台任务 ID,也不需要客户端轮询。
Maven 路径优先级为 --maven-repo → MAVEN_REPO → ~/.m2/settings.xml 的 localRepository → Maven 安装目录的 conf/settings.xml → ~/.m2/repository。MAVEN_HOME / M2_HOME 用于定位 Maven 安装目录,不再拼接 /repository。原来依赖此行为的用户应显式配置 --maven-repo。
支持 ~、相对路径(相对于服务器启动工作目录)、${user.home} 和 ${env.NAME}。未解析的 settings 变量会给出错误,可通过启动参数覆盖。
本版本要求 mcp>=1.30,<2。read_jar_source 保持默认全文返回;group_prefix 按完整 groupId 前缀分段匹配,例如 org.springframework,原先使用中间子串的调用应相应调整。详见 1.4.0 变更说明。
以下命令从仓库根目录执行,适用于 macOS/Linux;已有 .venv 时可跳过环境创建:
uv venv .venv --python python3
uv pip install --python .venv/bin/python -e ".[dev]"
.venv/bin/python -m easy_code_reader --help
.venv/bin/python -m pytest -q
.venv/bin/python scripts/smoke_test.py
可编辑安装会加载当前仓库代码。冒烟脚本创建临时 Maven 仓库和真实编译的 JAR,通过 MCP stdio 验证工具发现、搜索、全文/分段读取、反编译、缓存及错误响应;成功时输出 "smoke": "passed" 和各步骤耗时。
使用 mcpServers JSON 配置的客户端,可将本地虚拟环境 Python 的绝对路径填入 command:
{
  "mcpServers": {
    "easy-code-reader-local": {
      "command": "/absolute/path/to/easy-code-reader/.venv/bin/python",
      "args": [
        "-m",
        "easy_code_reader",
        "--maven-repo",
        "/absolute/path/to/maven/repository"
      ]
    }
  }
}
项目使用 stdio 通信,由 MCP 客户端启动服务进程。手动启动后等待输入是正常行为。修改代码后需要断开并重新连接,让 Python 进程重新加载模块。
构建并检查分发包:
.venv/bin/python -m build
.venv/bin/python -m twine check dist/*
Windows 中将 .venv/bin/python 替换为 .venv/Scripts/python.exe,并使用对应终端的路径语法。
完成本地可编辑安装后,可使用以下已验证的 Inspector 2.7.0 命令(macOS/Linux)。仓库路径以 ~/.m2/repository 为例,可替换为实际路径:
npx --registry=https://registry.npmjs.org -y \
  @modelcontextprotocol/[email protected] \
  "$PWD/.venv/bin/python" -- \
  -m easy_code_reader \
  --maven-repo "$HOME/.m2/repository"
此命令为本次下载指定 npm 官方源,不修改全局 npm 配置。Inspector 会启动本地 Web 界面;打开终端打印的完整地址,其中包含本次会话的访问令牌。
- 在 Servers 中选择预填的本地服务,点击 Connect。
- 进入 Tools,确认存在
search_group_id和read_jar_source。 - 先用
search_group_id查询artifact_id=spring-core、group_prefix=org.springframework,选择本地实际存在的版本。 - 调用
read_jar_source读取org.springframework.core.SpringVersion,将prefer_sources设为false,连续调用两次。无有效缓存时第一次返回decompiled,后续返回decompiled_cache;若已有有效缓存,第一次也可以命中缓存。 - 可再设置
start_line、end_line验证分段读取;不使用可选参数时,在表单中省略对应字段。
工具返回在 Tools 中查看,进程 stderr 在 Console 中查看,协议请求与响应在 Protocol 中查看。修改代码后断开再连接即可重新加载。
输入为本地 Maven 坐标和完整 Java 类名,依赖需要预先下载或安装到仓库中。读取顶层/基础版本的类路径,暂不处理嵌套 JAR 或 Multi-release 的运行时版本选择。
Apache License 2.0,详见 LICENSE 文件。

